LMArena (Arena) : le classement des modèles IA en octobre 2026
LMArena, devenu Arena : comment fonctionne ce classement des IA par votes humains, qui est en tête au 2 octobre 2026 (Gemini 4 Argon, modèles Claude) et comment le lire.
 10 min de lecture
Arena (ex-LMArena, rebaptisée en janvier 2026 et accessible sur arena.ai) est la plateforme de référence pour comparer les modèles d’IA grâce à des duels anonymes jugés par des humains. Au 2 octobre 2026, son classement texte compte 413 modèles et plus de 8,6 millions de votes. Il est dominé par les modèles Claude d’Anthropic, avec Gemini 4 Argon de Google en tête depuis sa sortie fin septembre.
Arena (ex-LMArena) classe les IA par votes humains à l’aveugle : au 2 octobre 2026, Gemini 4 Argon de Google est en tête du classement texte (score encore provisoire), suivi de près par les modèles Claude d’Anthropic. Lisez les scores avec leur marge d’erreur et préférez l’arena de votre usage (code, vision, image) au classement général.
Résumer cet article avec :
 ChatGPT
 Perplexity
 Claude
 Grok
En résumé
Arena classe les modèles d’IA d’après les votes des internautes, qui comparent deux réponses sans savoir quel modèle les a écrites. Au 2 octobre 2026, Gemini 4 Argon (Google) est premier du classement texte avec 1525 points, un score encore provisoire, devant claude-opus-4-6-high (1505). Le classement change chaque semaine : vérifiez-le sur arena.ai avant de choisir un modèle.
LMArena AI répond à la question que tout le monde se pose : quel modèle d’IA est vraiment le meilleur ? Contrairement aux benchmarks techniques classiques (MMLU, HumanEval), Arena mesure les préférences humaines réelles via des millions de duels anonymes. Résultat : un classement qui reflète ce que les utilisateurs trouvent réellement utile, pas seulement ce que les entreprises annoncent dans leurs communiqués.
Qu’est-ce que LMArena AI (devenu Arena) ?
Arena est né en 2023 comme projet de recherche à l’Université de Californie à Berkeley sous le nom Chatbot Arena, porté par le groupe LMSYS (Wei-Lin Chiang, Anastasios Angelopoulos et Ion Stoica). Il est devenu LMArena en 2024, puis une société indépendante en 2025. Son financement suit la montée en puissance de la plateforme :
- mai 2025 : 100 millions de dollars en amorçage, pour une valorisation de 600 millions de dollars ;
- 6 janvier 2026 : 150 millions de dollars en série A, pour une valorisation d’environ 1,7 milliard de dollars ;
- 28 janvier 2026 : rebaptisation en Arena, avec le domaine arena.ai.
Quelques ordres de grandeur pour mesurer l’audience :
- plus de 5 millions d’utilisateurs mensuels dans 150 pays (début 2026) ;
- plus de 60 millions de conversations par mois (début 2026) ;
- 413 modèles et 8 626 731 votes dans le classement texte au 2 octobre 2026 ;
- plus de 359 millions de sessions cumulées sur l’ensemble de la plateforme.
Le nom LMArena reste très utilisé dans la communauté : c’est le même outil, simplement rebaptisé. Sur Hugging Face, l’espace historique est toujours publié sous l’identifiant lmarena-ai.
Comment fonctionne Chatbot Arena (LMArena) ?
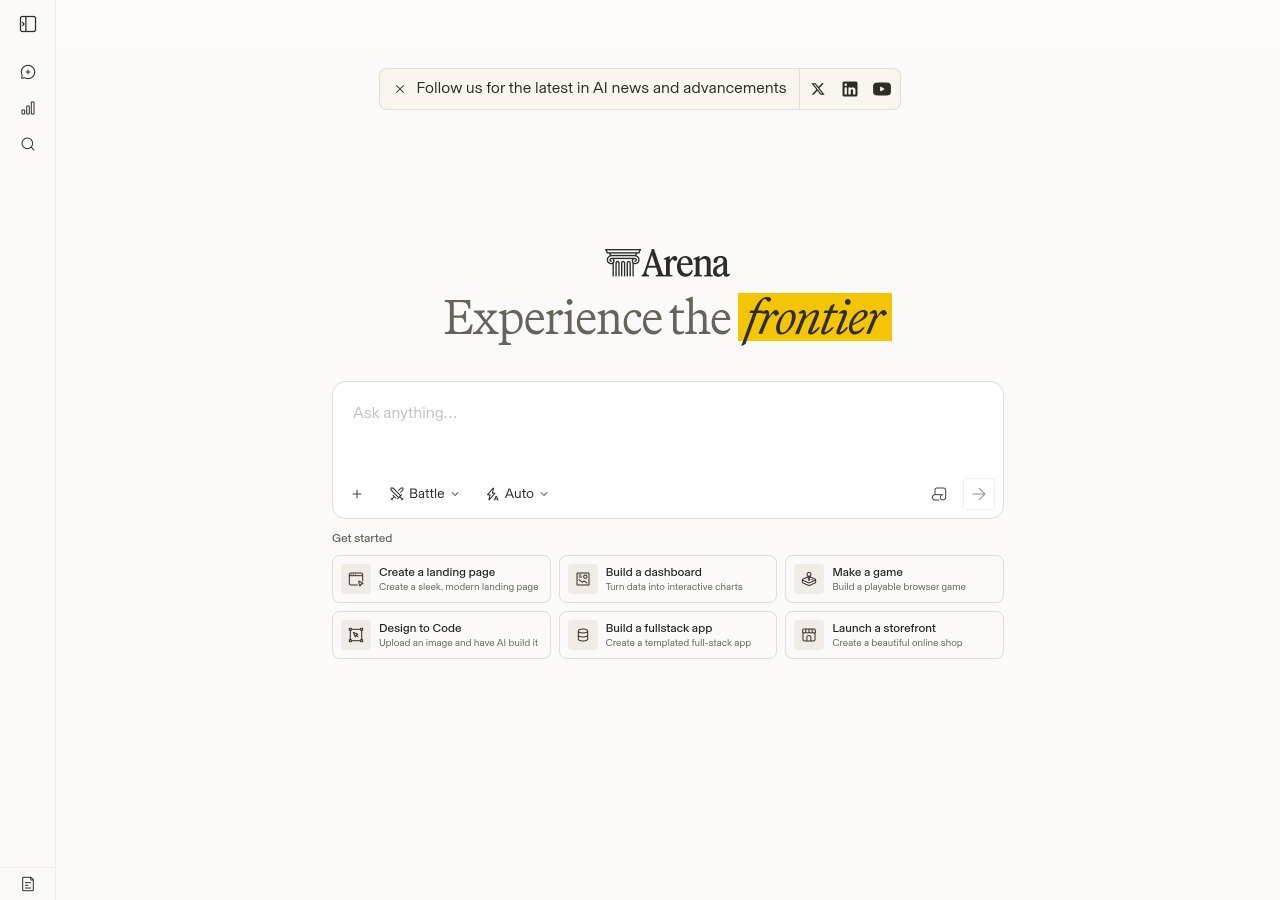
Le principe est simple. Vous arrivez sur arena.ai, vous posez une question ou un prompt, et vous recevez deux réponses en parallèle. Vous ne savez pas quel modèle a produit quelle réponse : c’est le cœur du système, l’aveuglement garanti.
- Vous saisissez votre prompt (question, demande de rédaction, problème de code…) ;
- Arena affiche deux réponses anonymisées (« Modèle A » et « Modèle B ») ;
- Vous votez pour la meilleure réponse, ou vous déclarez une égalité ;
- Arena révèle l’identité des modèles après votre vote ;
- Votre vote alimente le calcul du score de chaque modèle.
Le score s’inspire du système Elo des échecs : un modèle gagne des points quand il bat un adversaire mieux classé. En pratique, Arena s’appuie sur un modèle statistique de comparaisons par paires proche de l’Elo, et la plateforme a publié sa méthodologie de classement en open source (projet Arena-Rank). Les scores sont recalculés en continu à chaque nouveau vote.
Pourquoi l’anonymat est crucial
Sans anonymat, les utilisateurs voteraient pour les marques qu’ils connaissent (OpenAI, Google) indépendamment de la qualité. L’aveuglement force un jugement basé sur la qualité perçue de la réponse, ce qui rend le classement plus représentatif que les benchmarks auto-déclarés des fabricants.
Le classement Arena texte au 2 octobre 2026
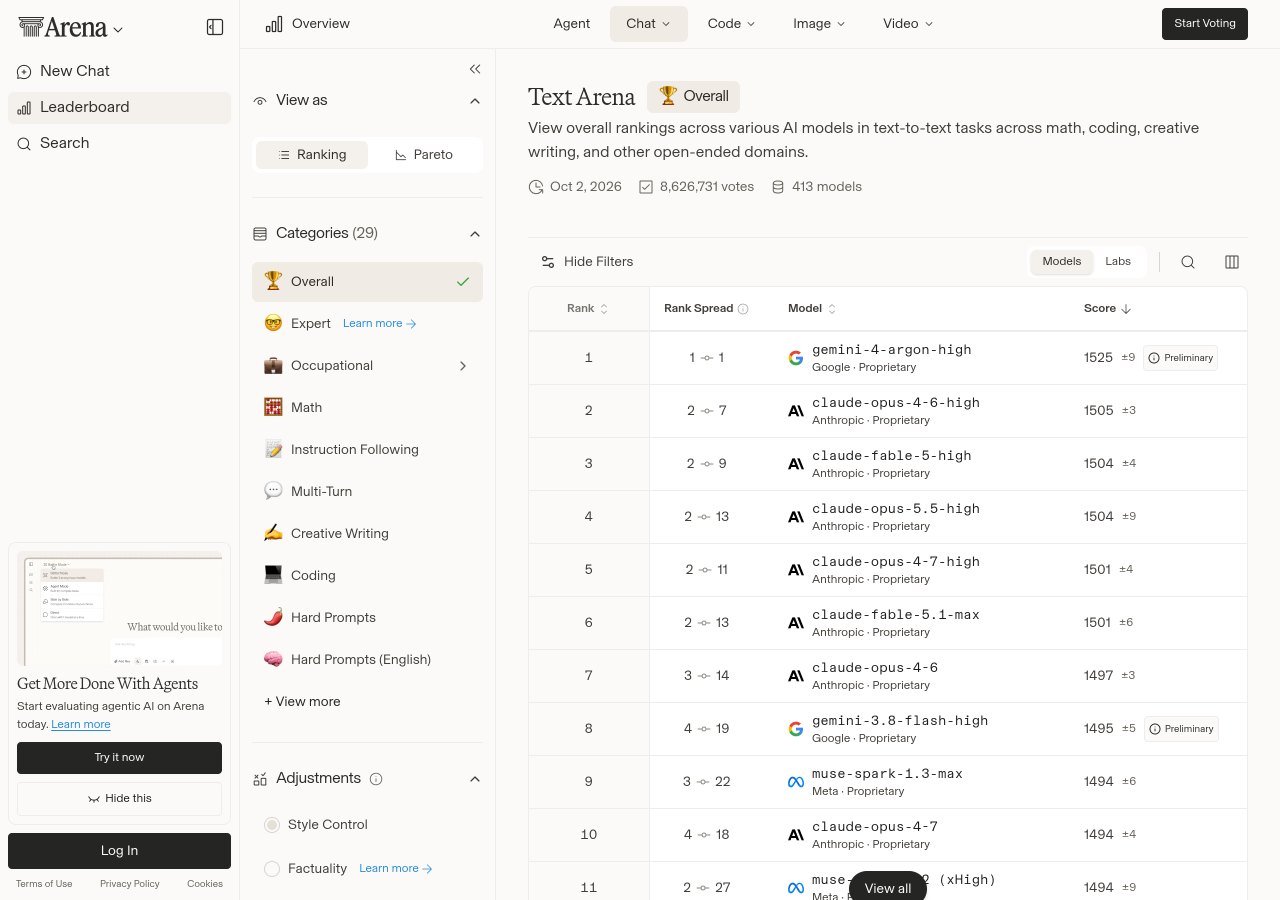
Le leaderboard évolue chaque semaine avec les nouvelles sorties de modèles. Voici le haut du classement général (vue « Overall ») à la date du 2 octobre 2026, avec les scores et leur marge d’erreur :
| Rang | Modèle | Éditeur | Score |
|---|---|---|---|
| 1 | Gemini 4 Argon (high) | 1525 ±9 (provisoire) | |
| 2 | Claude Opus 4.6 (high) | Anthropic | 1505 ±3 |
| 3 | Claude Fable 5 (high) | Anthropic | 1504 ±4 |
| 4 | Claude Opus 5.5 (high) | Anthropic | 1504 ±9 |
| 5 | Claude Opus 4.7 (high) | Anthropic | 1501 ±4 |
| 6 | Claude Fable 5.1 (max) | Anthropic | 1501 ±6 |
| 7 | Claude Opus 4.6 | Anthropic | 1497 ±3 |
| 8 | Gemini 3.8 Flash (high) | 1495 ±5 (provisoire) | |
| 9 | Muse Spark 1.3 (max) | Meta | 1494 ±6 |
| 10 | Claude Opus 4.7 | Anthropic | 1494 ±4 |
Comment lire ce tableau. Le premier, Gemini 4 Argon, a été annoncé par Google le 30 septembre 2026 et n’a encore reçu que 4 932 votes, contre plus de 77 000 pour Claude Opus 4.6 (high) : Arena le marque donc « provisoire ». Son avance de 20 points s’accompagne d’une marge d’erreur de 9 points, et l’accès au modèle reste restreint à ce stade. Derrière lui, sept des neuf places suivantes reviennent à des modèles d’Anthropic, séparés par quelques points seulement.
Et les autres éditeurs ? Au 2 octobre 2026, le meilleur modèle d’OpenAI est classé 20e, celui d’Alibaba 23e, celui de DeepSeek 38e et celui de xAI 50e. Le meilleur modèle de Mistral, Mistral Medium 3.5, est 115e, ce qui rappelle que le champion français vise d’abord les usages professionnels et l’ouverture des modèles : voir notre guide sur Mistral AI.
| Éditeur | Meilleur modèle classé | Rang texte |
|---|---|---|
| OpenAI | GPT-5.6 Sol (xhigh) | 20 |
| Alibaba | Qwen 3.8 Max | 23 |
| DeepSeek | DeepSeek V4.1 Flash (max) | 38 |
| xAI | Grok 4.5 | 50 |
| Mistral | Mistral Medium 3.5 | 115 |
Les arenas thématiques d’Arena
Arena n’évalue plus seulement le texte. L’interface propose aujourd’hui des onglets Agent, Chat, Code, Image et Video, et le classement texte se décline en 29 catégories (Expert, Math, Instruction Following, Multi-Turn, Creative Writing, Coding, Hard Prompts…). Un modèle peut être premier en texte et moyen en code, d’où l’intérêt de consulter l’arena qui correspond à votre usage :
| Arena | Modèle en tête | Relevé |
|---|---|---|
| Text (conversation, rédaction) | Gemini 4 Argon (high), 1525, score provisoire | 2 octobre 2026 |
| Vision (analyse d’images) | Claude Fable 5 (high), 1309, devant Qwen 3.8 Max | 2 octobre 2026 |
| Text-to-Image (génération d’images) | GPT Image 2.5 (sunburst), 1424, devant d’autres versions de GPT Image | 24 septembre 2026 |
| Text-to-Video (génération vidéo) | Gemini Omni 1.1 Flash, 1516 | 21 septembre 2026 |
| Search (recherche web augmentée) | GPT-5.6 Sol (xhigh), 1257, devant Claude Opus 4.6 (search) | 24 août 2026 |
| WebDev (code web) | Claude Sonnet 5.5 (xHigh), d’après la vue d’ensemble du classement | octobre 2026 |
| Agent | Claude Fable 5.1 (max), d’après la vue d’ensemble du classement | octobre 2026 |
Peut-on vraiment faire confiance au classement Arena ?
Question légitime, que la communauté pose régulièrement. Les limites réelles du système :
- Biais de population : les votants sont majoritairement des développeurs anglophones. Les préférences pour des tâches en français ou des cas métiers très spécifiques peuvent diverger ;
- Manipulation potentielle : des études ont montré que des votes truqués peuvent fausser un classement ;
- Versions de test : en avril 2025, Meta avait fait classer une version expérimentale de Llama 4 Maverick, différente de la version publique, ce qui a relancé le débat sur la transparence des soumissions ;
- Biais de nouveauté : un modèle tout juste sorti est évalué sur peu de votes, d’où le label « provisoire » ;
- Marge d’erreur : chaque score est donné avec une marge (de ±3 à ±9 points en ce moment). Deux modèles dont les marges se chevauchent sont difficiles à départager.
Arena propose aussi des réglages pour corriger certains biais, comme le « Style Control », qui limite l’effet de la longueur et de la mise en forme des réponses. Malgré ses limites, Arena reste l’un des benchmarks les plus indépendants et les plus utiles pour choisir un modèle, bien plus parlant que les chiffres publiés par les fabricants eux-mêmes. La clé : utiliser l’arena thématique de votre usage plutôt que le classement général.
Comment utiliser Arena et participer
- Rendez-vous sur arena.ai : l’accès est gratuit, un compte pouvant être demandé pour certaines fonctions ;
- Choisissez le mode Battle (duel anonyme) ou la discussion directe avec un modèle précis ;
- En mode Battle : saisissez votre prompt, lisez les deux réponses, votez ;
- Après le vote : poursuivez la conversation pour affiner, ou lancez un nouveau duel ;
- Consultez le classement dans l’onglet Leaderboard de la plateforme.
Astuce d’usage : pour choisir le meilleur modèle pour votre usage, faites 10 à 15 duels avec des prompts représentatifs de ce que vous faites vraiment (code Python, analyse juridique, rédaction marketing…). Notre guide pour créer de bons prompts vous aidera à les formuler. Le classement général ne remplace pas votre propre test.
Bénéfices pour les développeurs et entreprises
- Choisir le bon modèle API : avant de migrer d’un modèle à un autre, Arena permet de vérifier le gain de qualité perçu sur des prompts représentatifs ;
- Calibrer ses attentes : si deux modèles ont des scores dont les marges d’erreur se chevauchent, le moins cher est probablement le meilleur choix. Notre comparatif Claude, GPT, Gemini ou Mistral détaille les usages ;
- Suivre les évolutions : le classement bouge vite, un contrôle trimestriel suffit pour savoir si un nouveau modèle s’impose dans sa catégorie ;
- Soumettre un modèle : les éditeurs peuvent demander l’évaluation de leur modèle, la procédure est décrite sur arena.ai.
Alternatives à Arena pour évaluer les modèles IA
| Plateforme | Approche | Point fort |
|---|---|---|
| Arena (ex-LMArena) | Duels anonymes par votes humains | Reflète la préférence réelle des utilisateurs |
| Artificial Analysis | Indice agrégé de benchmarks, avec prix et vitesse | Vue synthétique qualité, coût et rapidité |
| MMLU / GPQA | Tests académiques standardisés | Référence pour le raisonnement et les sciences |
| SWE-bench | Benchmark de code sur de vrais tickets GitHub | Le plus parlant pour évaluer les agents de code |
Pour aller plus loin
- DeepSearch : la recherche IA agentique, que l’on retrouve dans l’arena Search
- Mistral AI : le modèle français, évalué sur Arena
- Guide prompt IA : pour créer de bons prompts de test
- Stack IA rentable 2026 : choisir les bons modèles pour sa stack
FAQ : questions fréquentes sur LMArena (Arena)
C’est quoi LMArena ?
LMArena, rebaptisée Arena en janvier 2026 (arena.ai), est une plateforme qui classe les modèles d’IA grâce à des duels anonymes : l’utilisateur compare deux réponses sans savoir quel modèle les a produites, vote pour la meilleure, et le score des modèles est mis à jour. Née à l’Université de Berkeley en 2023, elle compte plus de 5 millions d’utilisateurs mensuels.
Quel est le classement des meilleures IA sur Arena ?
Au 2 octobre 2026, Gemini 4 Argon de Google est premier du classement texte avec 1525 points (score provisoire), suivi de claude-opus-4-6-high (1505), claude-fable-5-high (1504) et claude-opus-5.5-high (1504). Les modèles Claude d’Anthropic occupent la majorité du haut du classement, qui évolue chaque semaine.
LMArena est-il gratuit ?
Oui. L’accès à arena.ai, aux duels et au classement est gratuit. Un compte peut être demandé pour certaines fonctions, comme conserver son historique.
Quelle est la différence entre LMArena et les benchmarks classiques ?
Les benchmarks classiques (MMLU, GPQA, HumanEval) mesurent des capacités techniques sur des tests standardisés. Arena mesure les préférences humaines sur des prompts réels. Un modèle peut scorer haut sur un test académique et produire des réponses que les humains trouvent moins utiles, et inversement.
Peut-on faire confiance au classement d’Arena ?
Il reste l’un des plus indépendants, mais il a des limites : biais de population (surtout des développeurs anglophones), risque de votes truqués, scores provisoires pour les modèles récents et marge d’erreur de plusieurs points. Mieux vaut consulter l’arena de son usage et tester soi-même.
Quel est le LLM français le mieux classé ?
Mistral Medium 3.5, de Mistral AI, est le meilleur modèle français du classement texte, à la 115e place au 2 octobre 2026. Mistral vise surtout les usages professionnels et les modèles ouverts, et a annoncé un modèle de nouvelle génération sans date de sortie.
Comment soumettre un modèle à Arena ?
Les éditeurs de modèles peuvent demander l’évaluation de leur modèle auprès d’Arena. La procédure est décrite sur arena.ai. Le modèle doit être accessible, par exemple via une API, pour être soumis à des duels à l’aveugle contre d’autres modèles.